논수리는 인문논술 문제 풀이에 AI 해설을 제공하는 교육 서비스입니다. AI 모델을 선택할 때 벤치마크 점수만으로 판단하는 대신, 사용자의 재응시율, 결제율, 문제풀이율을 바탕으로 실제 서비스 성과를 비교하는 방식으로 기준을 바꿨습니다.
ABTO로 기존 세팅과 새 세팅을 비교한 논수리는 모델 비용 41% 감소와 재응시율 18% 증가를 확인했습니다. 어떤 어려움에서 시작했고, 무엇을 기준으로 변화를 확인했는지 질문과 답변으로 정리했습니다.
기존에는 AI 모델을 선택함에 있어 어떤 어려움이 있었나요?
벤치마크만으로는 우리 서비스에 알맞은 모델을 선택하기 어려웠습니다. 코딩이나 수학 벤치마크는 저희 유저도, 논수리의 해설과도 관련이 없었죠. 모델의 전반적인 성능은 참고할 수 있지만, 그 모델이 논수리 사용자에게도 잘 맞는지는 별개의 문제였습니다.
저희에게 중요한 것은 사용자가 해설을 읽은 뒤 다시 문제를 푸는지, 결제로 이어지는지, 문제 풀이를 계속하는지였습니다. 그런데 벤치마크 점수만으로는 이런 행동을 알 수 없었어요.
처음에는 성능이 좋다고 알려진 모델을 사용했습니다. 그런데 모델 비용은 매달 늘어나는 반면, 그 비용이 사용자의 재응시로 이어지는지는 확인하기 어려웠습니다. 우리 서비스에서 얻는 성과와 비용을 함께 비교할 기준이 필요했습니다.
그렇다면 어떤 기준으로 모델을 선택하기로 했나요?
사용자의 재응시율, 결제율, 문제풀이율을 기준으로 실제 서비스 성과를 보려고 했습니다. 벤치마크를 보지 않겠다는 뜻은 아닙니다. 점수와 함께 그 모델을 경험한 사용자가 어떤 행동을 하는지 확인하려는 것이었습니다.
예를 들어 해설을 제공한 뒤 사용자가 다시 문제를 푸는지, 유료 이용으로 이어지는지, 문제 풀이를 이어가는지를 살펴보는 것입니다. 모델별 호출 비용과 사용자 행동을 따로 보면, 비용은 얼마인지 알더라도 그 모델을 경험한 사용자가 다시 문제를 풀었는지는 연결해서 보기 어렵습니다. 두 데이터를 함께 놓고, 어떤 세팅에서 어떤 행동이 나타나는지 비교할 필요가 있었습니다.
이번 비교에서는 그중 재응시율을 중심으로 두 세팅의 차이를 확인했습니다. 해설을 읽은 사용자가 다시 문제를 풀러 오는지를 보고자 했습니다.
ABTO를 통해 두 세팅을 어떻게 비교했나요?
ABTO 내에 논수리의 AI 해설 기능을 연결했습니다. 같은 기능을 사용하는 사람들을 다른 모델로 나눠서 테스트했는데, 한쪽에는 기존 세팅을 유지하고 다른 쪽에는 새 세팅을 적용했습니다.
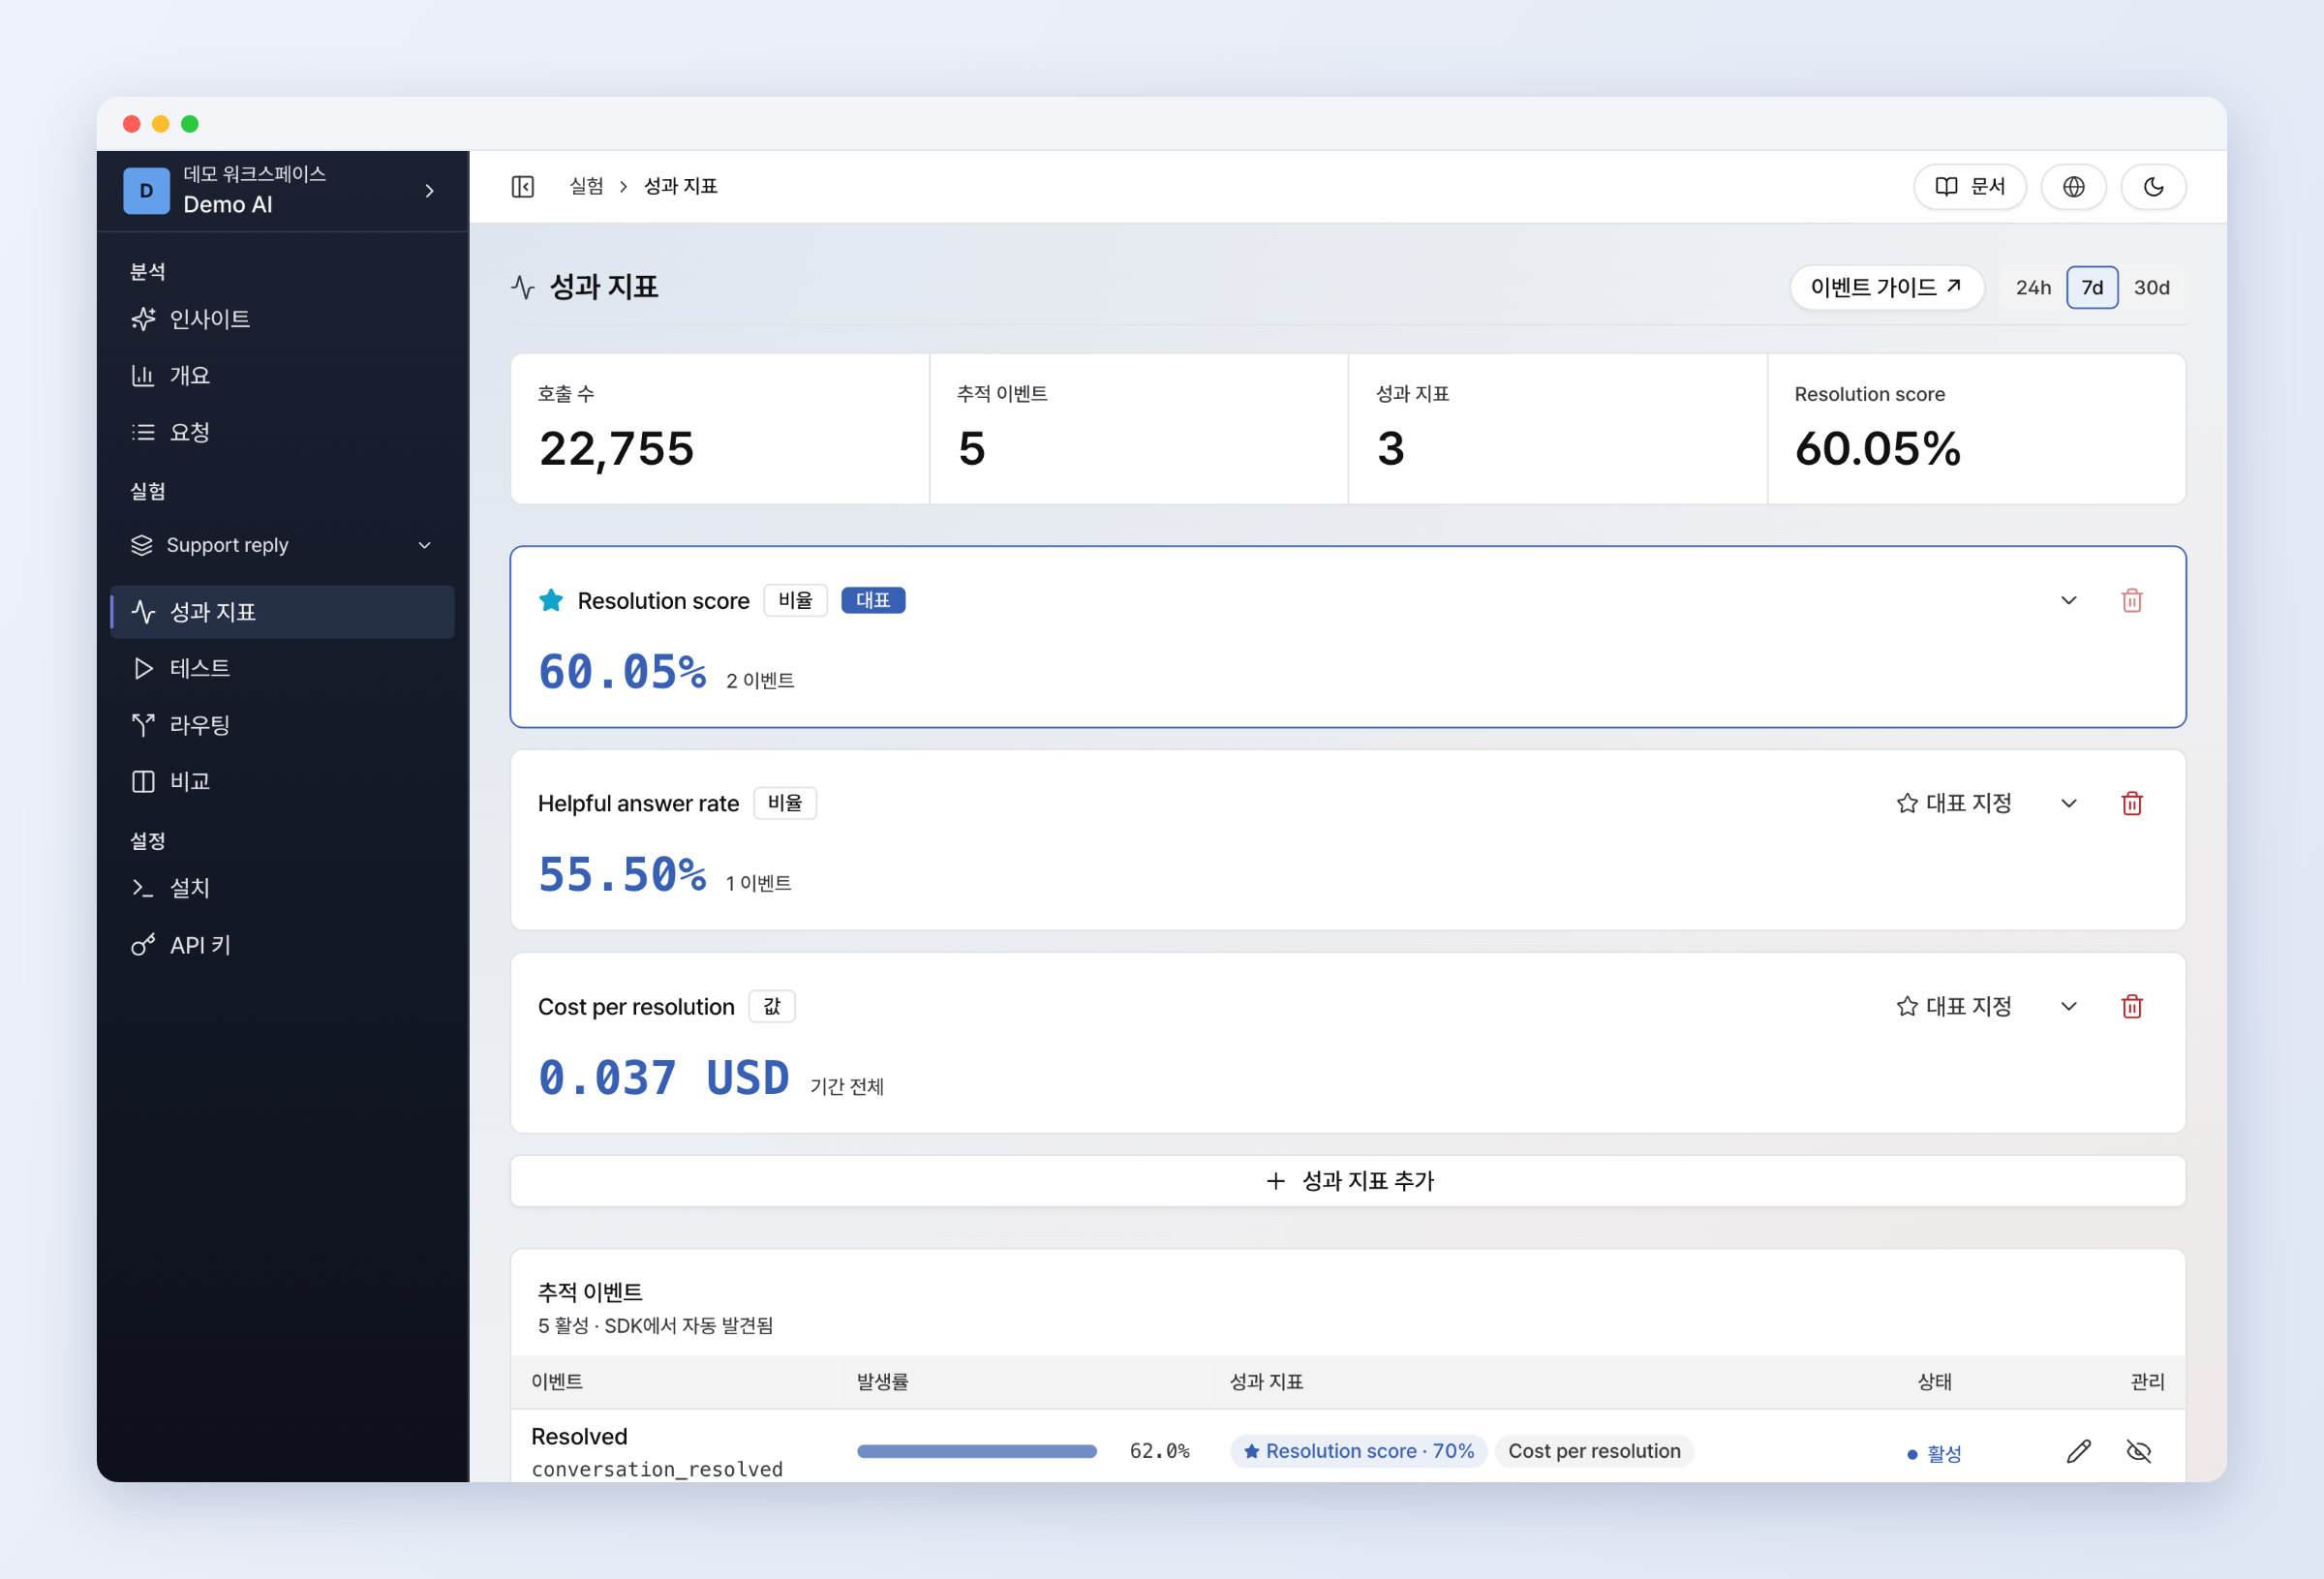
먼저 ABTO에서 논수리의 성과 지표를 설정했어요. 논수리의 주요 성과로 보고 싶었던 것은 결제 액션율, 채점 점수, 문제 풀이 후 추가 액션 비율, 평균 호출 당 비용 등이었어요. 이후 새로 비교해보고 싶었던 GPT luna 모델 세팅을 기존 세팅과 유저 트래픽을 나누어 비교해보았습니다.
새 세팅은 실제 사용자에게 어떻게 적용했나요?
처음부터 모든 사용자에게 적용하지는 않았습니다. 먼저 사용자 10%에게만 적용하고, 며칠 동안 에러율과 응답 속도 및 성과 지표 변화가 있는지를 확인했습니다.
운영상 문제가 없다는 것을 확인한 뒤에는 적용 비율을 50%로 서서히 높였습니다. 일부 사용자에게 먼저 적용하면서 잘 작동하는지 확인한 다음 차근차근 높여나가면서 문제 발생에 대비할 수 있어서 좋았어요.
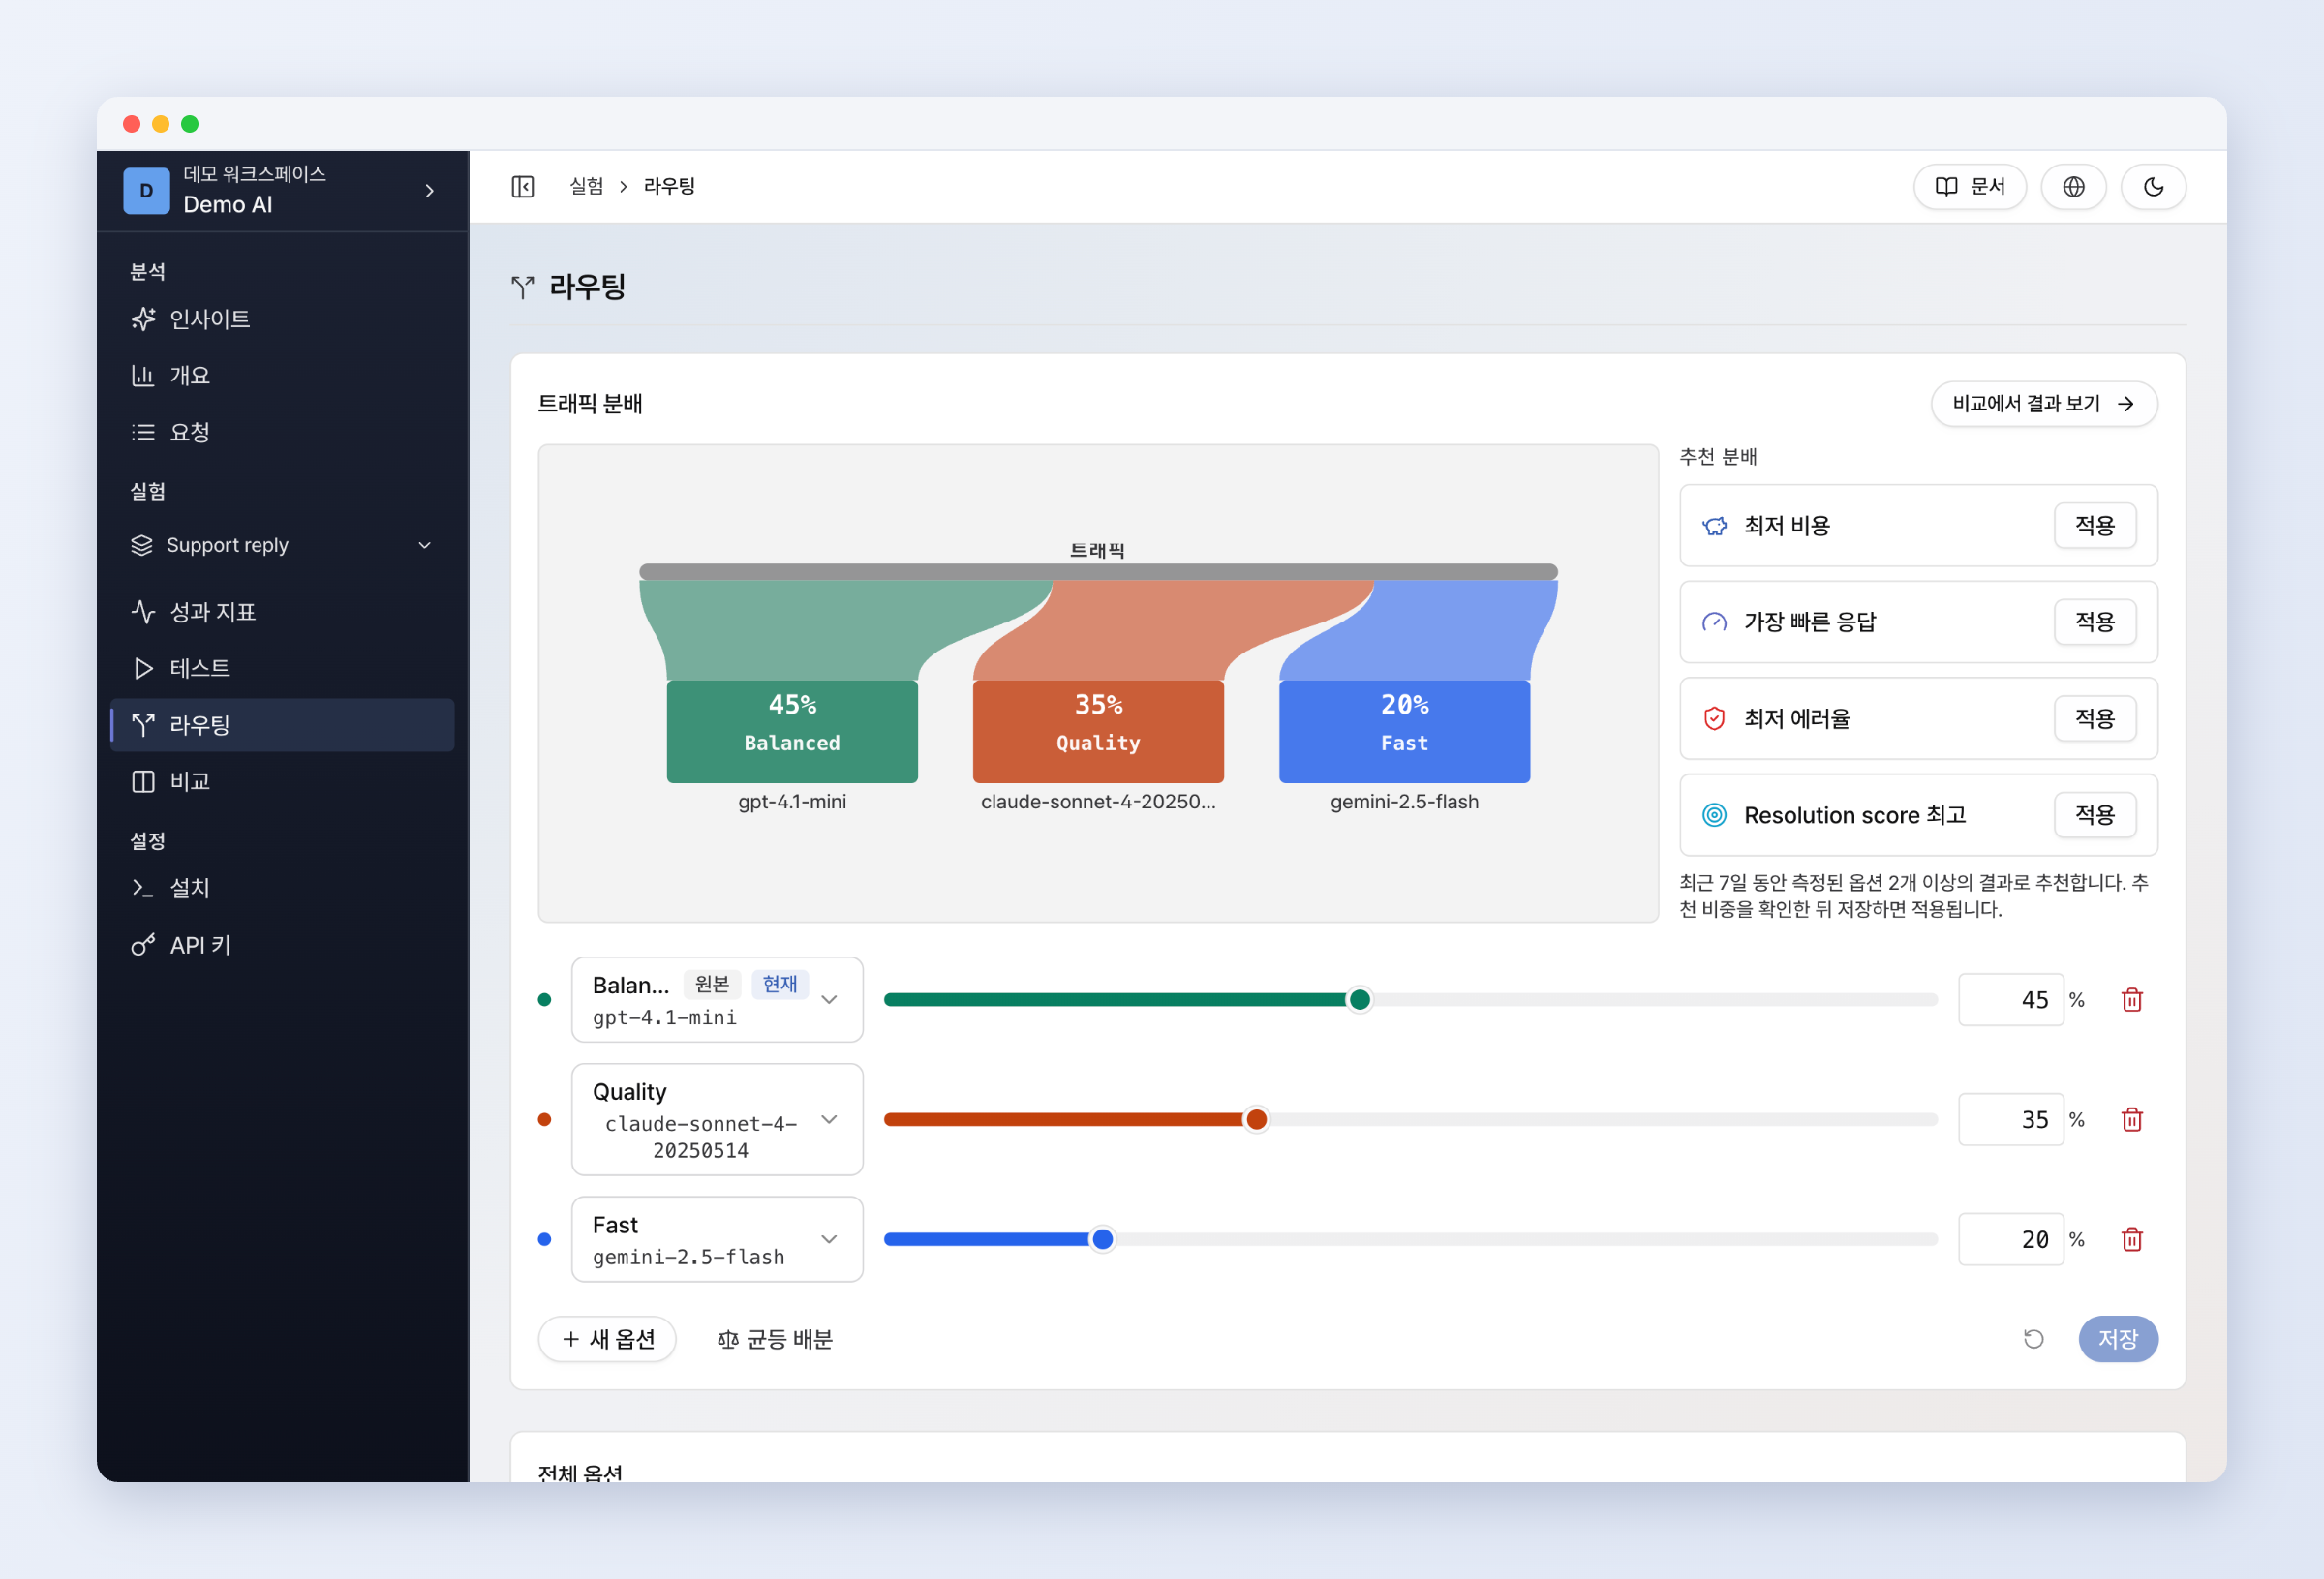
처음에는 기간이 짧아 결과가 매번 달라졌는데 데이터가 쌓일 때까지 기다리며 계속 비교해보았어요.
비교 결과, 어떤 변화가 있었나요?
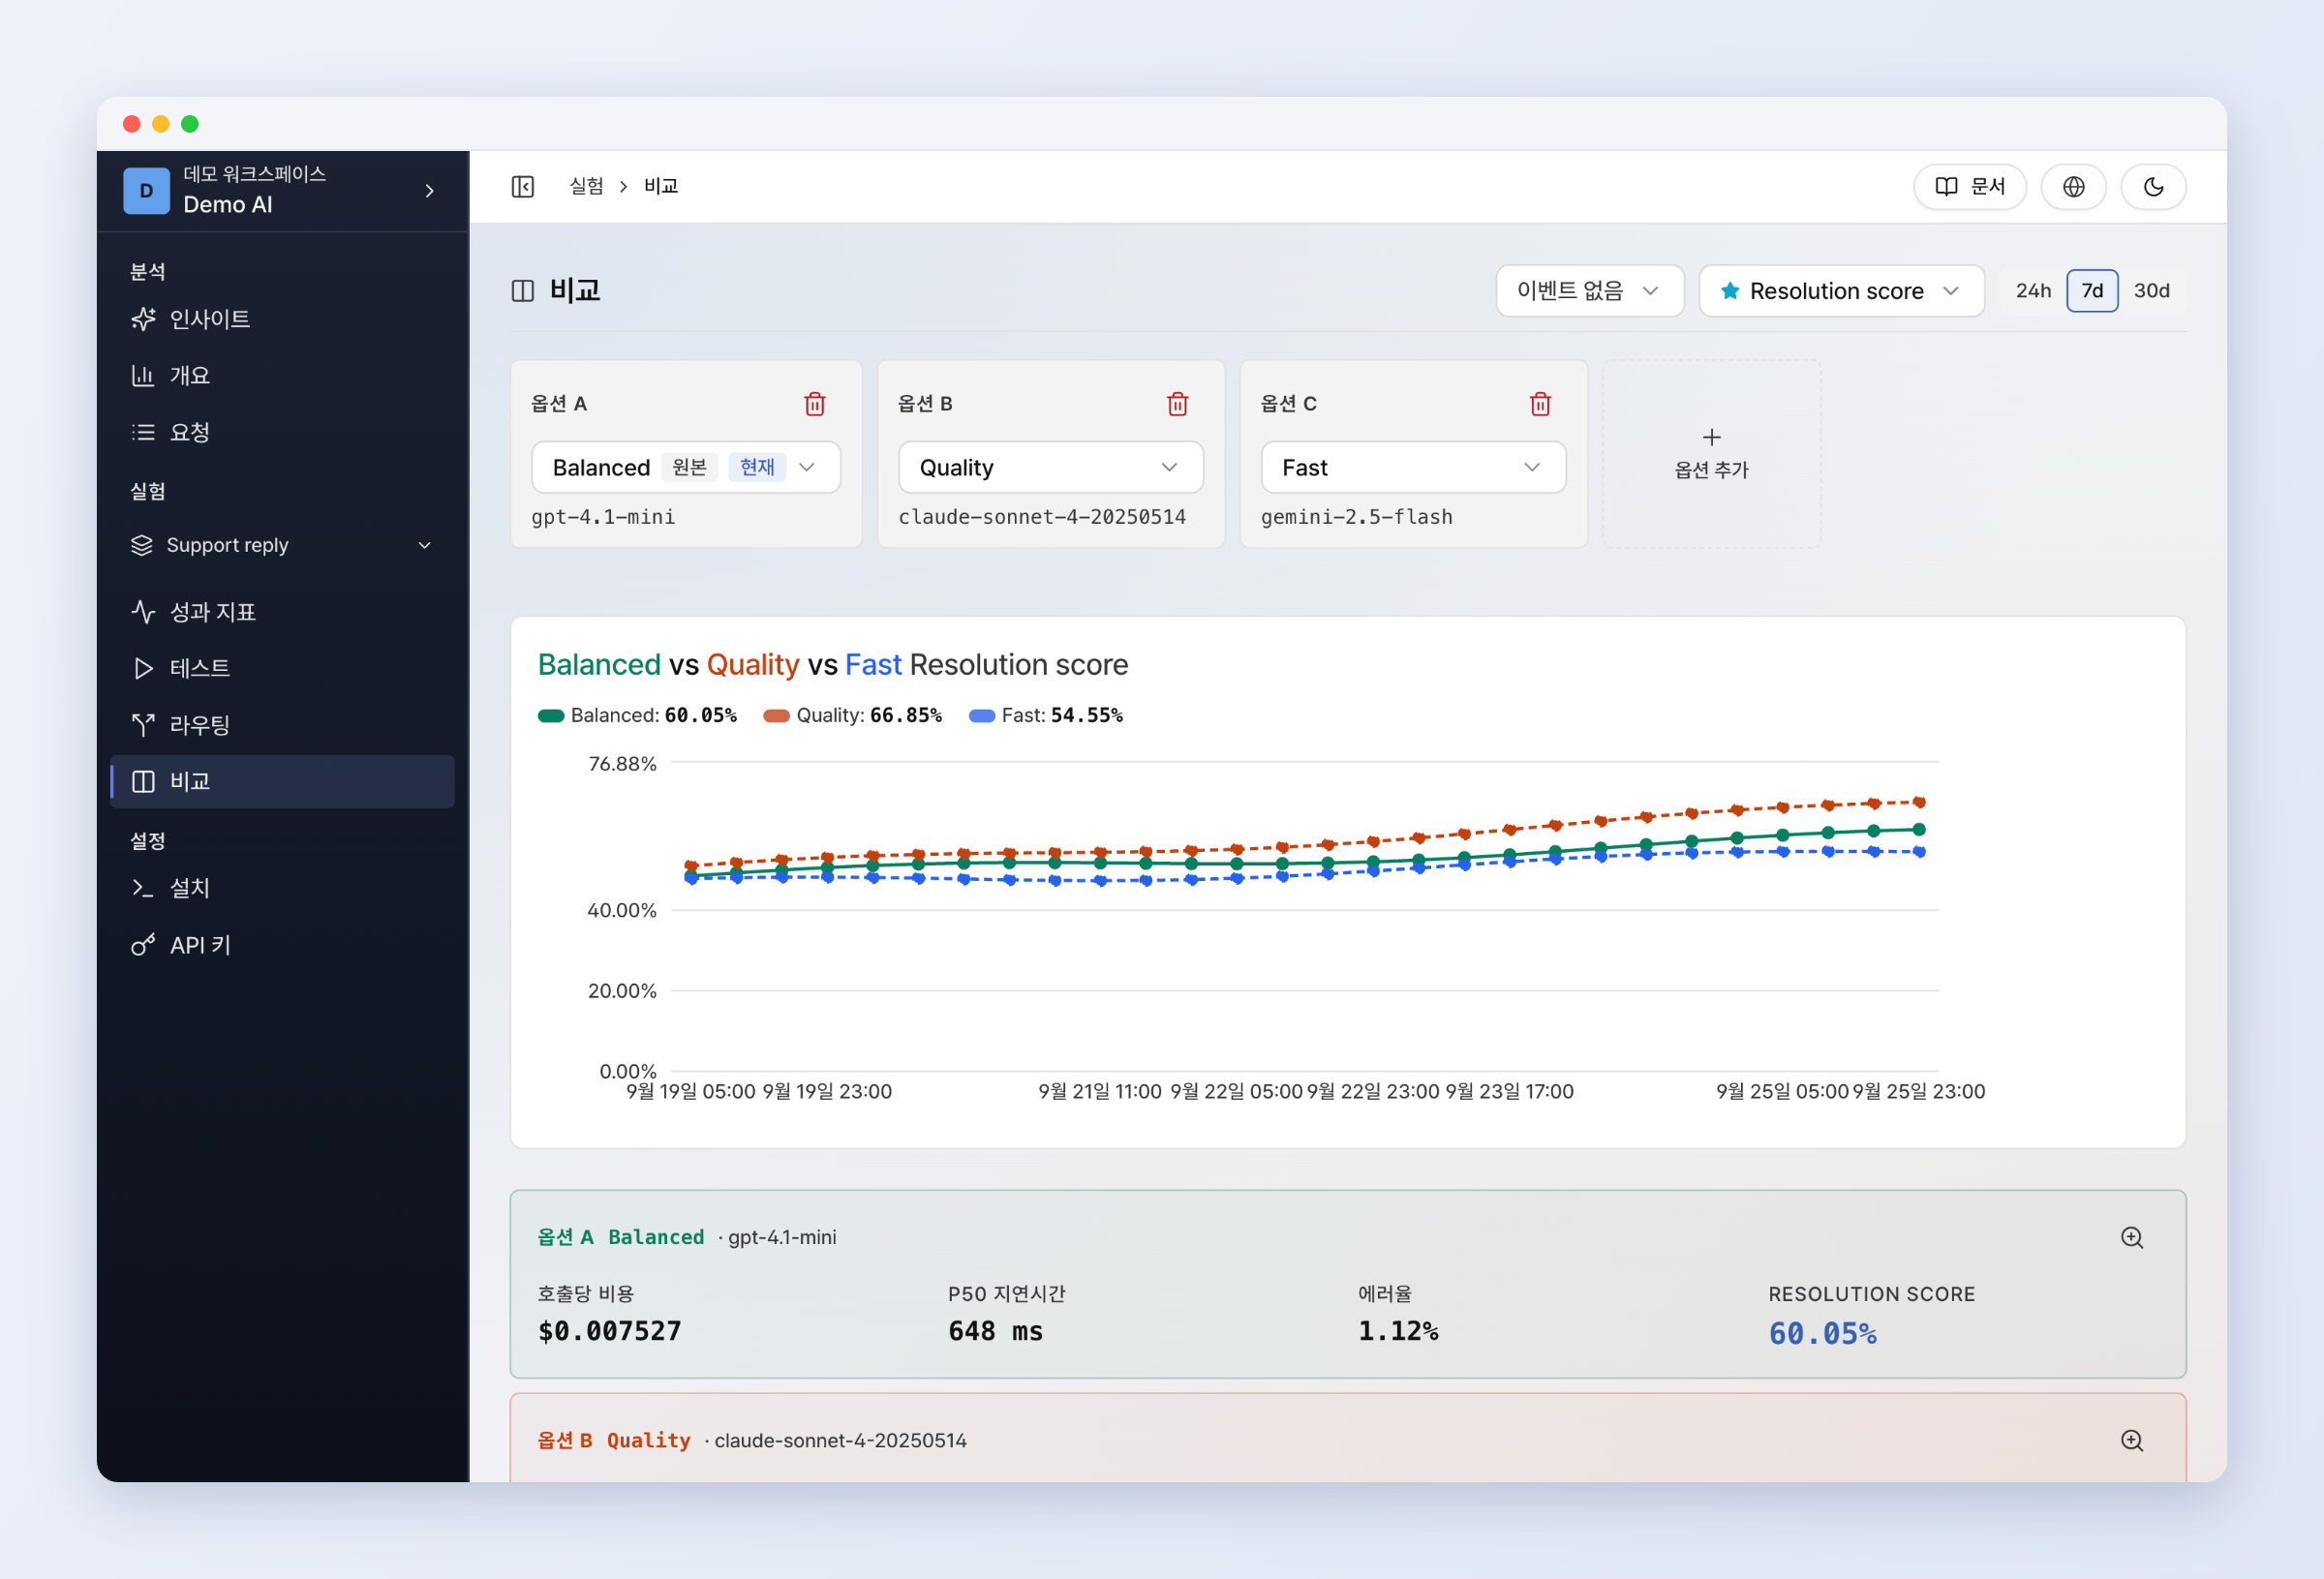
일주일 이상 지속 추적한 결과 새로운 세팅에서 모델 비용은 41% 줄고, 재응시율은 18% 증가했습니다. 논술 문제에 대한 해설을 다 읽고 다음 문제로 넘어가는 비율도 높아졌습니다.
성과 지표 기반으로 고객이 더 좋아하는 모델을 선택했는데 실제로 비싼 모델이 아니었고, AI 모델 단가를 낮출 수 있었습니다. 비용만 낮아진 것이 아니라 재응시율도 함께 높아졌다는 점이 이번 비교에서 확인한 변화였습니다.
이번 비교 이후, 모델을 선택하는 방식은 어떻게 달라졌나요?
벤치마크 점수나 모델의 평판에 더해, 우리 사용자의 행동을 판단 근거로 삼게 됐습니다. 좋다고 알려진 모델인지뿐 아니라, 그 모델을 사용하는 사람이 다시 문제를 푸는지와 그 결과를 얻는 데 얼마의 비용이 드는지를 함께 보게 된 것입니다.
재응시율, 결제율, 문제풀이율처럼 서비스 목적에 맞는 지표로 모델을 판단하고, 이번에는 재응시율과 비용을 실제로 비교해 볼 수 있었습니다. 비싼 모델과 긴 답변이 항상 최선인 것은 아니었습니다. 저렴한 모델이 항상 더 낫다는 결론이 아니라, ABTO를 통해 우리 서비스에 맞는 AI 모델 세팅을 사용자 반응으로 직접 확인해보고 바꿀 수 있어서 좋았습니다.
논수리는 ABTO를 통해 서비스에 맞는 행동 지표를 정하고, 일부 사용자에게 새 세팅을 적용한 뒤, 데이터가 쌓이면 비용과 성과를 함께 비교했습니다. AI 모델 선택이 고민이라면 우리 서비스에서 확인할 사용자 행동부터 정하고 이를 ABTO에서 빠르게 확인해보세요.
앱토(ABTO)는 비용과 사용자 반응을 한 화면에서 비교하는 AI 모델 A/B 테스트 도구입니다.
에이전트에 ABTO 스킬을 설치하고 /abto ABTO 연동해줘라고 요청하면 5분 안에 연동할 수 있습니다.